Ultra-schnelle KI-Inferenz mit 10 GSPS erkennt Teilchen-Pile-up in Echtzeit
Ein FPGA-basiertes CNN lokalisiert jedes Teilchen im Teilchenstrahl bei GSI/FAIR mit einer Latenz von 300 ns bei einem Durchsatz von 120 Gbit/s – selbst wenn sich Detektorimpulse überlagern.
www.spdevices.com
Die FPGA-basierte KI-Inferenz mit 10 Gigasamples pro Sekunde (GSPS) auf dem Teledyne ADQ35 ermöglicht am GSI Helmholtzzentrum für Schwerionenforschung in Darmstadt eine zuverlässige und präzise Teilchenlokalisierung in Echtzeit – mit einer Latenz von unter einer Mikrosekunde und einer zeitlichen Auflösung im Subnanosekundenbereich, selbst bei hohen Teilchenraten und erheblicher Signalüberlagerung. Die Arbeiten wurden im Rahmen einer Promotion an der Hochschule Fulda in Zusammenarbeit mit GSI durchgeführt. Ein direkt auf dem FPGA implementiertes Convolutional Neural Network (CNN) verarbeitet 120 Gigabit pro Sekunde bei einer Latenz von nur 300 Nanosekunden.
Jedes Teilchen im Spill erfassen
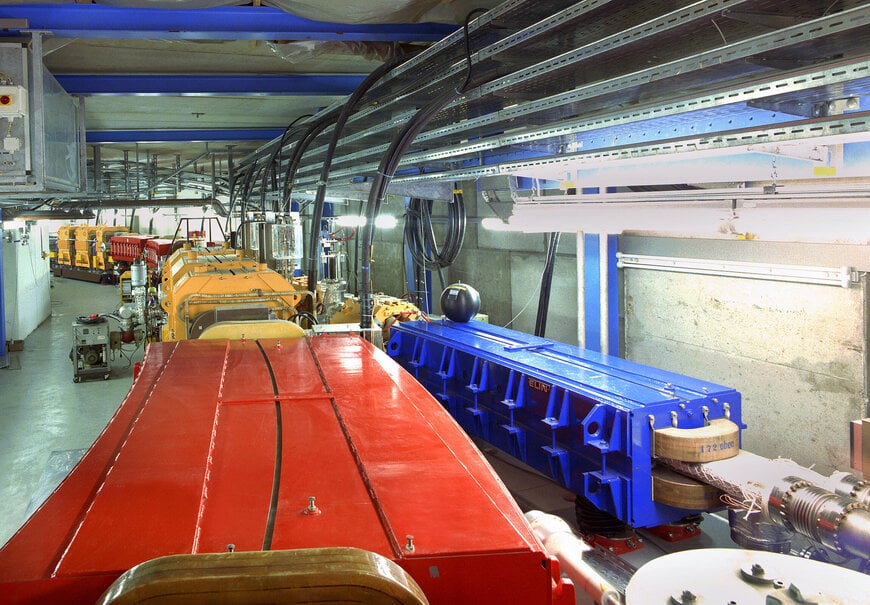
Teilchenbeschleuniger liefern präzise kontrollierte Teilchenstrahlen für wissenschaftliche Experimente, die Materialforschung und medizinische Anwendungen. Am GSI beschleunigt der Synchrotronbeschleuniger SIS18 die Teilchen im Ringbeschleuniger und führt den Strahl anschließend den Experimenten zu, indem Teilchen aus dem Strahl extrahiert werden – der sogenannte Spill. Für die Spill-Steuerung ist es entscheidend zu wissen, wie viele Teilchen sich im Spill befinden und wie sie zeitlich verteilt sind. Um dies sicherzustellen, muss jedes Teilchen im Spill während des Beschleunigerbetriebs in Echtzeit lokalisiert werden – eine anspruchsvolle Aufgabe in der Strahldiagnostik von Teilchenbeschleunigern.
Ein Detektor wird in den Strahl eingebracht und erzeugt für jedes durch ihn hindurchtretende Teilchen einen Impuls. Dies ist in Abbildung 1 dargestellt. Passieren mehrere Teilchen den Detektor innerhalb eines kurzen Zeitintervalls, überlagern sich die Impulse und die Detektorantwort kann nichtlinear werden. Dieses Ereignis überlappender Impulse wird als Pile-up bezeichnet. Seine Wahrscheinlichkeit steigt mit zunehmender Strahlintensität. Können Pile-up-Ereignisse nicht zuverlässig aufgelöst werden, muss ihr Auftreten vermieden werden, wodurch die Strahlintensität begrenzt wird.
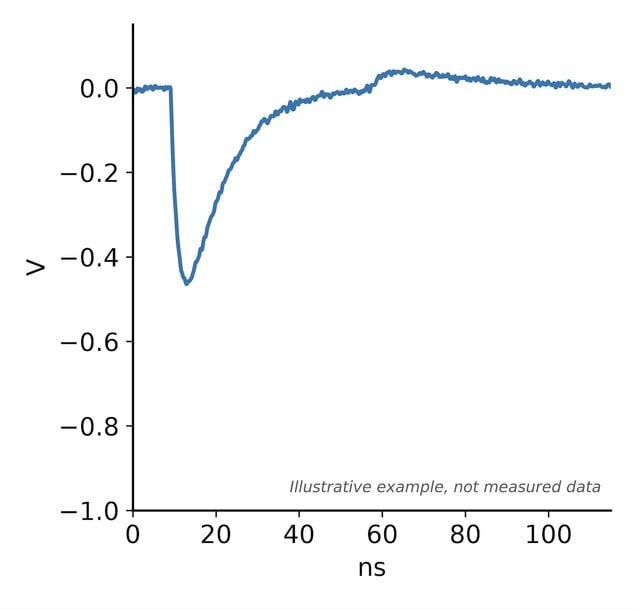
Abbildung 1. Der Impuls, der entsteht, wenn ein Teilchen auf den Detektor trifft.
Abbildung 2 zeigt vier Beispiele für dieses Pile-up-Phänomen. Jedes Beispiel zeigt die Signalantwort, wenn drei Teilchen innerhalb eines kurzen Zeitintervalls eintreffen. Die Ankunftszeit jedes Teilchens ist durch eine grün gepunktete Linie dargestellt.
Herkömmliche Verfahren wie die Detektion mit mehreren Schwellenwerten oder die Suche nach lokalen Maxima haben Schwierigkeiten und versagen häufig bei der Erkennung von Teilchen, wenn Pile-up auftritt. Dies führt zu einer Unterzählung, die sich negativ auf die Spill-Steuerung und nachgelagerte Experimente auswirken kann.
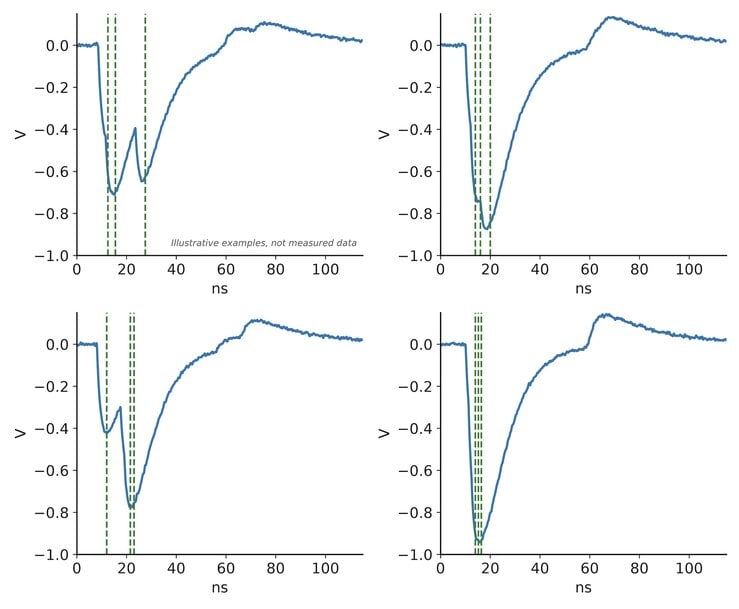
Abbildung 2. Die Detektorantwort, wenn mehrere Teilchen innerhalb eines kurzen Zeitintervalls eintreffen. Drei Teilchen treffen ein und ihre Impulse überlagern sich.
KI-basierte Signalverarbeitung auf dem FPGA
Um diese Herausforderung zu bewältigen, wurde ein CNN entwickelt und anhand annotierter Daten trainiert. Anschließend wurde es mithilfe einer von UFAIRA entwickelten Toolchain direkt auf FPGA-Hardware implementiert.
Das KI-Modell lokalisiert jeden einzelnen Impuls, selbst wenn Pile-up auftritt, und ermittelt dabei sowohl die Anzahl der Teilchen als auch deren Ankunftszeit in Echtzeit. Dadurch lässt sich der Spill selbst bei sehr hohen Raten präzise rekonstruieren. Die FPGA-Implementierung des CNN verarbeitet die Daten inline und gewährleistet eine deterministische Latenz, was für Echtzeitanwendungen wie die Spill-Steuerung von großer Bedeutung ist.
Implementierung auf dem Digitizer
Die Lösung basiert auf dem Hochgeschwindigkeits-Digitizer ADQ35 von Teledyne SP Devices mit Abtastraten von bis zu 10 GSPS und einem integrierten AMD Kintex UltraScale KU115 FPGA. Damit stehen umfangreiche Rechenressourcen für die KI-Inferenz in Echtzeit direkt auf dem Digitizer zur Verfügung. Durch die direkte Verarbeitung der Daten auf dem Digitizer werden Engpässe bei der Datenübertragung vermieden und Latenzen von unter einer Mikrosekunde ermöglicht.
Mithilfe einer Toolchain für FPGA-optimiertes, hardwarebewusstes Training und die Implementierung des CNN in der FPGA-Fabric kann das implementierte CNN 32 Samples parallel mit 312,5 MHz verarbeiten. Dies entspricht 10 GSPS bei niedriger und deterministischer Latenz sowie hoher Genauigkeit.
300 ns Latenz bei 120 Gbit/s
Das implementierte CNN erreicht eine Latenz von nur 300 Nanosekunden und verarbeitet 120 Gigabit pro Sekunde (10 GSPS bei 12 Bit pro Sample). Es beansprucht weniger als 15 % der verfügbaren DSP-Ressourcen und weniger als 6 % der verfügbaren LUT-Ressourcen des FPGA. Damit bleibt ausreichend Spielraum für noch größere Modelle oder eine höhere Datenrate.
Der KI-basierte Ansatz verbessert die Leistung unter Pile-up-Bedingungen deutlich und übertrifft herkömmliche Verfahren wie die Detektion mit mehreren Schwellenwerten und die Suche nach lokalen Maxima. Das CNN lokalisiert einzelne Impulse in Pile-up-Ereignissen so zuverlässig, dass Pile-up nicht mehr durch eine Reduzierung der Teilchenrate vermieden werden muss. Dadurch kann das System mit deutlich höheren Teilchenraten betrieben werden, ohne dass Änderungen an der Detektorhardware erforderlich sind.
Wann hilft KI bei der Echtzeit-Datenverarbeitung mit hoher Geschwindigkeit?
Dieses Beispiel zeigt, dass KI besonders dann relevant wird, wenn mehrere Ereignisse innerhalb desselben Zeitraums auftreten und ein überlagertes Signal erzeugen. KI kann aber auch dann helfen, wenn die Signalverarbeitung für herkömmliche Verfahren zu komplex ist oder wenn sich Signalformen aufgrund realer Einflüsse wie Drift, Rauschen und Nichtlinearität verändern. KI-Modelle können komplexes Signalverhalten erlernen und Informationen extrahieren, die sich mit herkömmlichen Verfahren in Echtzeit nur schwer oder gar nicht gewinnen lassen.
Der hier demonstrierte Ansatz lässt sich auf zahlreiche Bereiche der Hochgeschwindigkeitsdatenverarbeitung übertragen, die eine Inline-Verarbeitung mit geringer Latenz erfordern, darunter die Echtzeit-Spektrumüberwachung und Signalklassifizierung, die Kanalschätzung in HF-Systemen, der Hochfrequenzhandel, die Erkennung von Netzwerkeindringversuchen, die Bildverarbeitung für autonome Systeme und vieles mehr.
Über UFAIRA
Die in dieser Forschungsarbeit eingesetzten Methoden und die verwendete Toolchain bilden heute die Grundlage von UFAIRA, einem Unternehmen, das kundenspezifische FPGA-basierte KI-Beschleuniger für Echtzeit-Inferenz entwickelt. UFAIRA wurde 2026 als Spin-off aus der Promotionsforschung an der Hochschule Fulda gegründet.
Mehr erfahren unter: https://ufaira.eu/?utm_source=mepax
Über Teledyne SP Devices
Teledyne SP Devices ist ein Pionier auf dem Gebiet der Hochgeschwindigkeits-Datenerfassung und bietet fortschrittliche Digitizer- und Signalverarbeitungslösungen für anspruchsvolle Anwendungen weltweit. Mit einer langen Innovationsgeschichte, zu der auch eine frühe Vorreiterrolle bei der Digitizer-Technologie mit 10 GSPS gehört, unterstützt das Unternehmen seine Kunden dabei, Daten schneller, präziser und effizienter zu erfassen und zu verarbeiten.
Mehr erfahren unter: https://www.spdevices.com/en-us?utm_source=mepax
Fordern Sie weitere Informationen an…